Коалиция CLEAR исследовала, насколько экономно токенизаторы обрабатывают разные языки. Для сравнения использовали FLORES-200: набор предложений с профессиональными переводами примерно на 200 языков. Такой подход позволяет сопоставлять содержание, а не случайные тексты разной сложности.
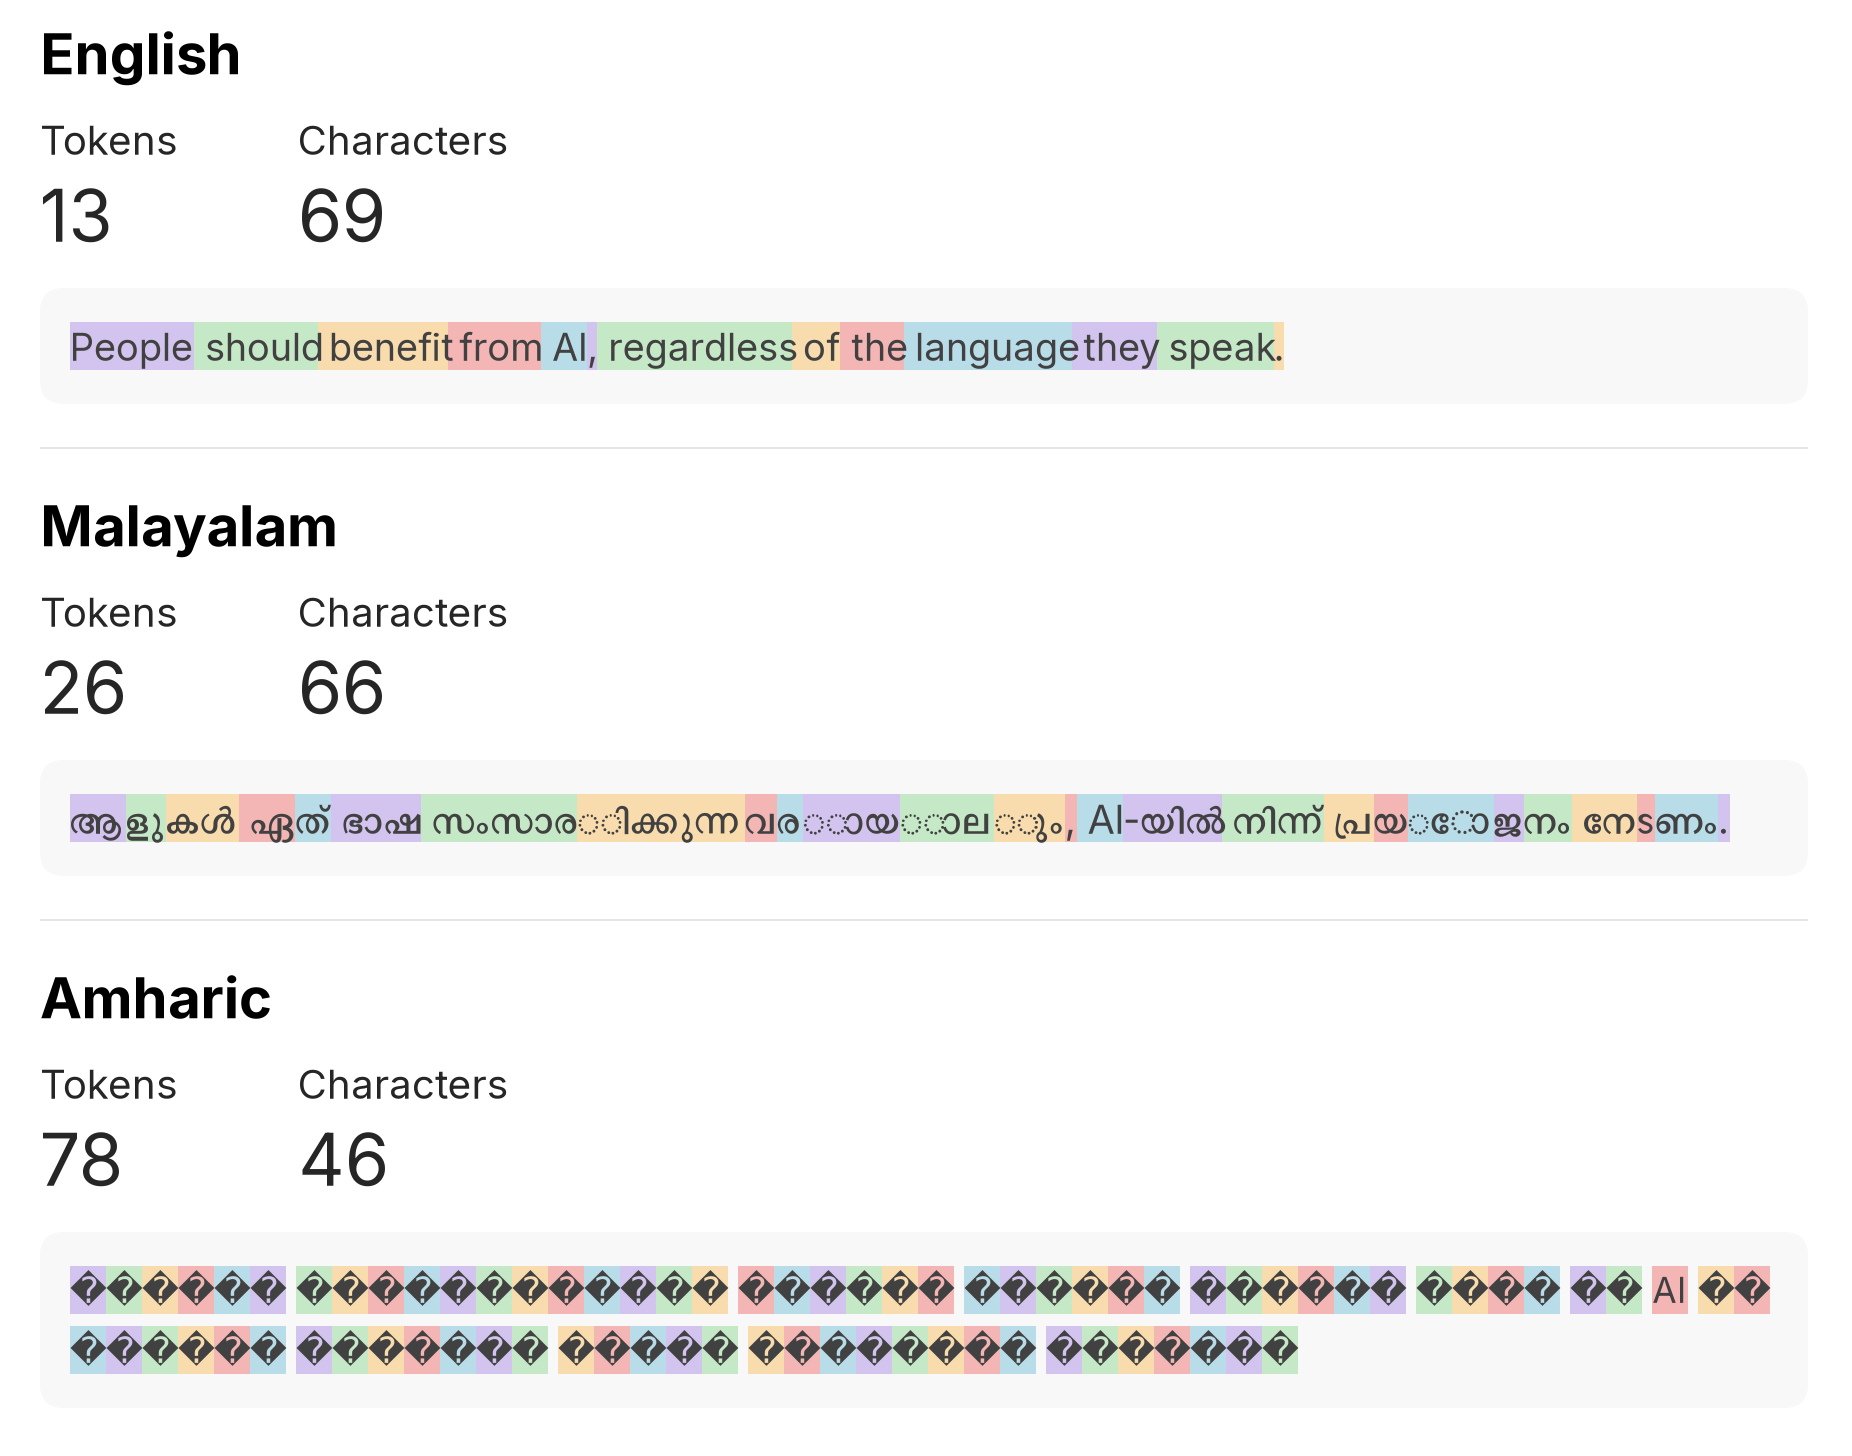
Токен — не обязательно целое слово. Алгоритм может выделить часть слова, отдельный знак или даже байт. Поэтому короткая фраза иногда занимает больше токенов, чем более длинный перевод. В приведённом авторами примере английскому предложению соответствуют 13 токенов, варианту на малаялам — 26, на амхарском — 78.
При сравнении всех языков исследователи обнаружили разрыв до 17 раз для отдельных токенизаторов. Это не универсальная надбавка к цене любого неанглийского запроса: результат зависит от модели, письменности и самого текста.
Разница важна не только для оплаты. При фиксированном контекстном окне дополнительные токены оставляют меньше места для документов и истории общения. Они также способны увеличивать вычислительную нагрузку и задержку ответа.
Авторы связывают проблему с инженерными решениями и недостаточным представлением некоторых письменностей в цифровых данных. Улучшать необходимо и многоязычные обучающие наборы, и сами алгоритмы токенизации.
Первоисточник и иллюстрация: CLEAR — The Tokenizer Tax. Дополнительный источник: 3DNews. Самостоятельный пересказ CYBERLAND.